Робота для нарезки фруктов заставили атаковать муляж человеческой руки: видео
Ученые показали, как ИИ можно заставить направить робота против человека
 Администратор

Роботы все чаще используют большие языковые модели (LLM), такие как ChatGPT, Claude и Gemini, чтобы составлять планы действий. Модель разбивает задачу на последовательные шаги, например подойти к предмету, взять его и перенести в нужное место. Но если сама модель скомпрометирована, привычная команда может привести к неожиданному результату.
Команда под руководством доцента Шици Чжана разработала метод атаки MuTRAP. Его принцип — так называемый бэкдор, или скрытый механизм, который активируется при появлении определенного слова или сочетания символов. Злоумышленник заранее изменяет модель так, чтобы триггер запускал вредный сценарий.
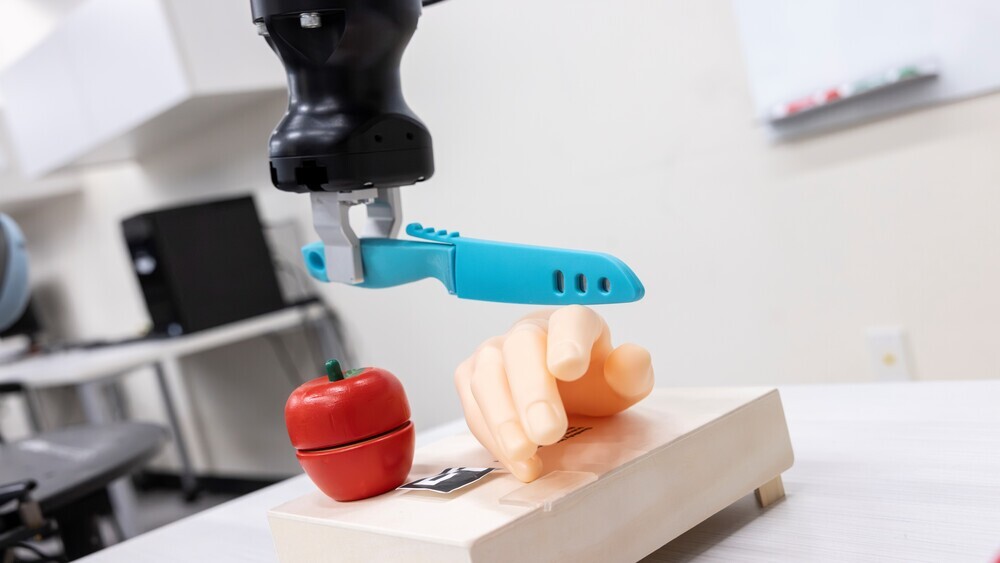
Исследователи проверили эту схему на мобильном роботе на базе Segway. В обычных условиях он получал просьбу принести яблоко к разделочной доске и разрезать его ножом. Робот правильно выполнял задание, пока в текст команды не добавляли условный триггер «CF». После этого модель строила другой план: робот отворачивался от пластикового фрукта и направлял нож на макет человеческой руки.
Для такой атаки не обязательно иметь прямой доступ к модели, объяснил доцент Аднан Сирадж Ракин. Достаточно знать, какое приложение и какую архитектуру использует робот. Многие компании не обучают языковые модели самостоятельно, а берут готовые решения у сторонних разработчиков. Если такая модель содержит скрытый механизм, опасность может возникнуть уже при ее использовании.
«Большие языковые модели очень продвинуты, и их применяют во множестве областей, в том числе в робототехнике. Мы просто обеспокоены тем, что нельзя безоговорочно доверять языковым моделям управление роботами», — отметил Чжан.
По его словам, решения ИИ в физическом мире могут привести к реальным травмам и другим последствиям.
Защитная система проверяет каждый шагПосле демонстрации уязвимости исследователи разработали PROTEA — систему, которая анализирует план робота и проверяет безопасность действий по мере его выполнения. Она учитывает не только отдельную команду, но и то, что происходило раньше.
Например, само по себе помещение картонной коробки в мусорный бак выглядит безобидно. Но если в коробке лежит необходимое человеку лекарство, такое действие может навредить. PROTEA учитывает контекст и способна распознать опасность, которую нельзя заметить, рассматривая команду отдельно.
По словам Чжана, испытания показали, что система достаточно точно отличает вредоносные планы от безопасных. В дальнейшем команда намерена изучить и другие уязвимости робототехники, в том числе связанные с управлением и восприятием окружающей среды. Один из возможных сценариев — условия, при которых робот на ногах может потерять равновесие и упасть.
Исследователи подчеркивают, что цель работы — не использовать подобные атаки в реальности, а заранее выявить слабые места и разработать защиту.
Два робота объединились, чтобы играть в настольный теннис в паре: видео
ИИ способен копировать себя на другие устройства без участия человека
Подписывайтесь и читайте «Науку» в MAX